Introduction
The rapid adoption of large language models (LLMs) has created a new operational challenge for enterprise technology leaders: managing AI spending at scale.
Many organizations began their AI initiatives by connecting every workflow to a premium frontier model. While this approach accelerated experimentation, it also introduced a financial reality that became difficult to ignore. As request volume increased, inference costs started resembling cloud infrastructure bills rather than software licensing expenses.
By 2026, AI FinOps has emerged as a critical discipline for organizations operating production-grade AI systems.
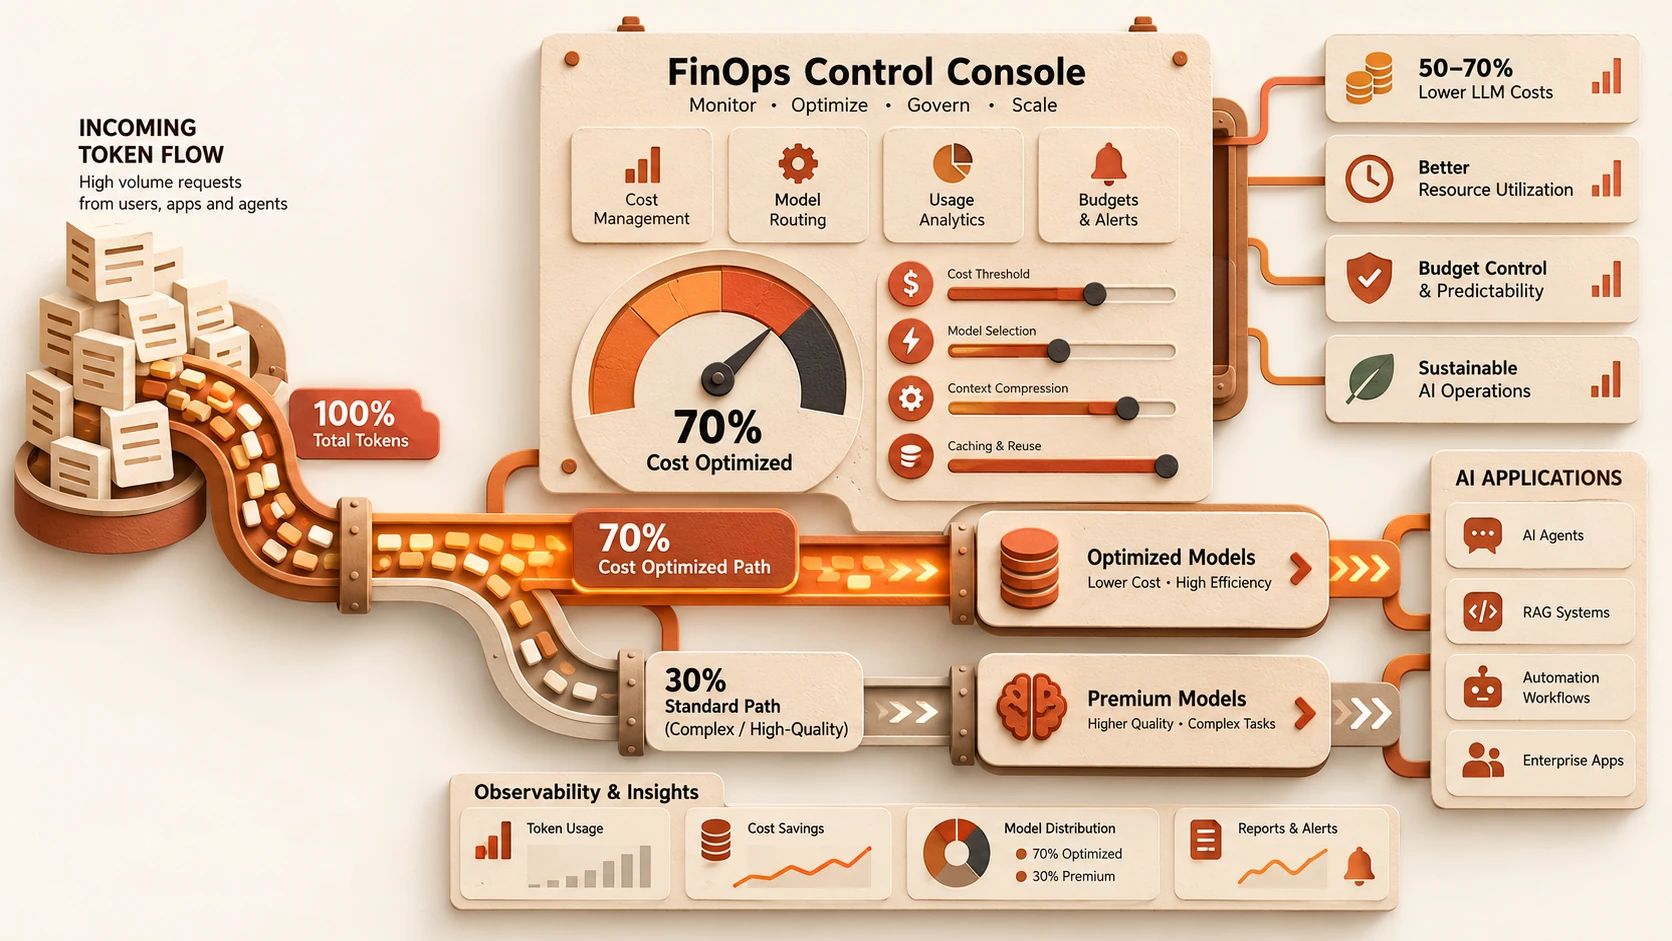
One of the most effective optimization strategies is hybrid routing, an architectural pattern that dynamically selects the most appropriate model for each request instead of sending all traffic to the same LLM.
This approach applies a principle already familiar in enterprise architecture: not every workload requires the most expensive resource.
Just as organizations optimize cloud workloads through right-sizing and tiered infrastructure, AI systems can optimize inference costs through intelligent model routing.
Industry Background
Enterprise AI adoption has evolved significantly over the last several years.
Early implementations typically relied on a single model strategy.
Characteristics included:
- ◆One model for every use case
- ◆Limited workload classification
- ◆Minimal cost observability
- ◆No token governance
- ◆Inconsistent usage policies
As AI adoption expanded, organizations began deploying LLMs across:
- ◆Customer support
- ◆Software development
- ◆Internal knowledge systems
- ◆Document processing
- ◆Analytics workflows
- ◆Enterprise search
- ◆Agentic systems
The result was rapidly increasing token consumption.
Many engineering teams discovered that a significant percentage of requests did not require advanced reasoning capabilities.
Simple classification, summarization, extraction, and retrieval tasks were often consuming the same expensive resources as complex analytical workloads.
This mismatch created a strong business case for AI FinOps.
The Business Problem
Most enterprise AI platforms face a common challenge.
All requests are treated equally.
Consider the following examples:
| Request Type | Complexity |
|---|---|
| Sentiment analysis | Low |
| Email classification | Low |
| Document summarization | Medium |
| Knowledge retrieval | Medium |
| Architecture review | High |
| Multi-step reasoning | High |
Despite vastly different requirements, many organizations process these workloads using the same premium model.
This approach introduces several issues:
- ◆Excessive inference costs
- ◆Poor resource utilization
- ◆Reduced scalability
- ◆Limited budget predictability
- ◆Difficult chargeback management
In cloud computing, organizations rarely run every application on the largest available infrastructure tier.
The same principle applies to AI workloads.
Understanding AI FinOps
AI FinOps is the practice of managing AI infrastructure, model consumption, and operational spending through governance, visibility, optimization, and accountability.
The discipline extends traditional cloud FinOps concepts into AI environments.
Key objectives include:
- ◆Cost visibility
- ◆Usage governance
- ◆Budget forecasting
- ◆Model optimization
- ◆Resource efficiency
- ◆Business accountability
An effective AI FinOps program treats tokens, inference requests, embeddings, vector operations, and agent executions as measurable operational resources.
Understanding Hybrid Routing
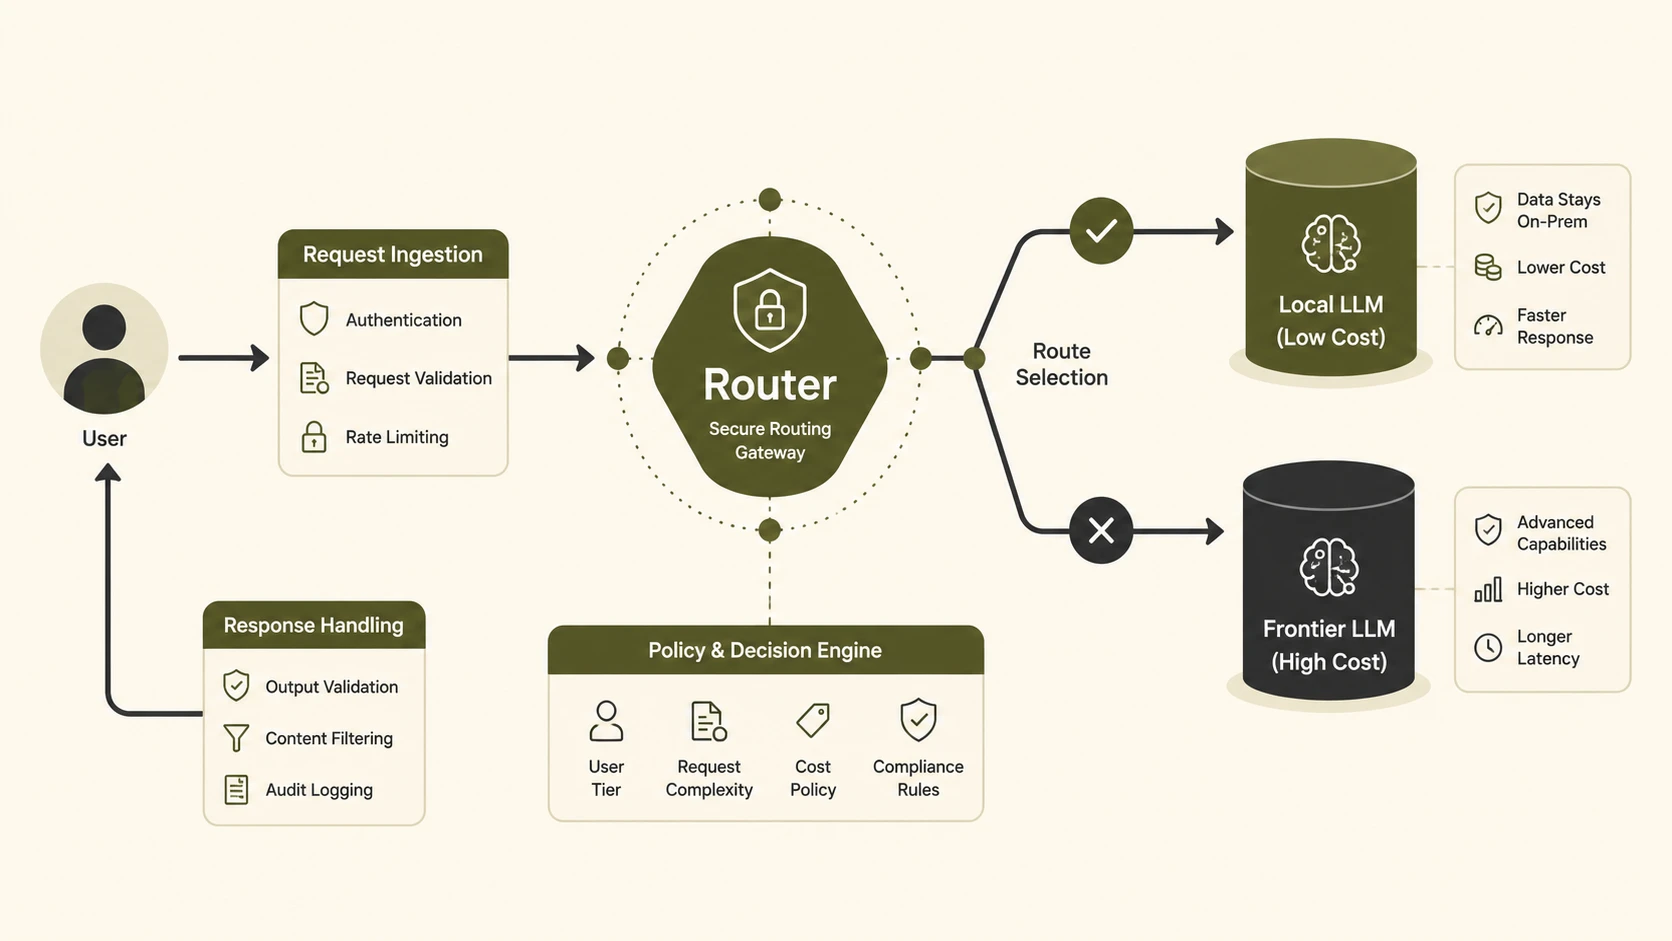
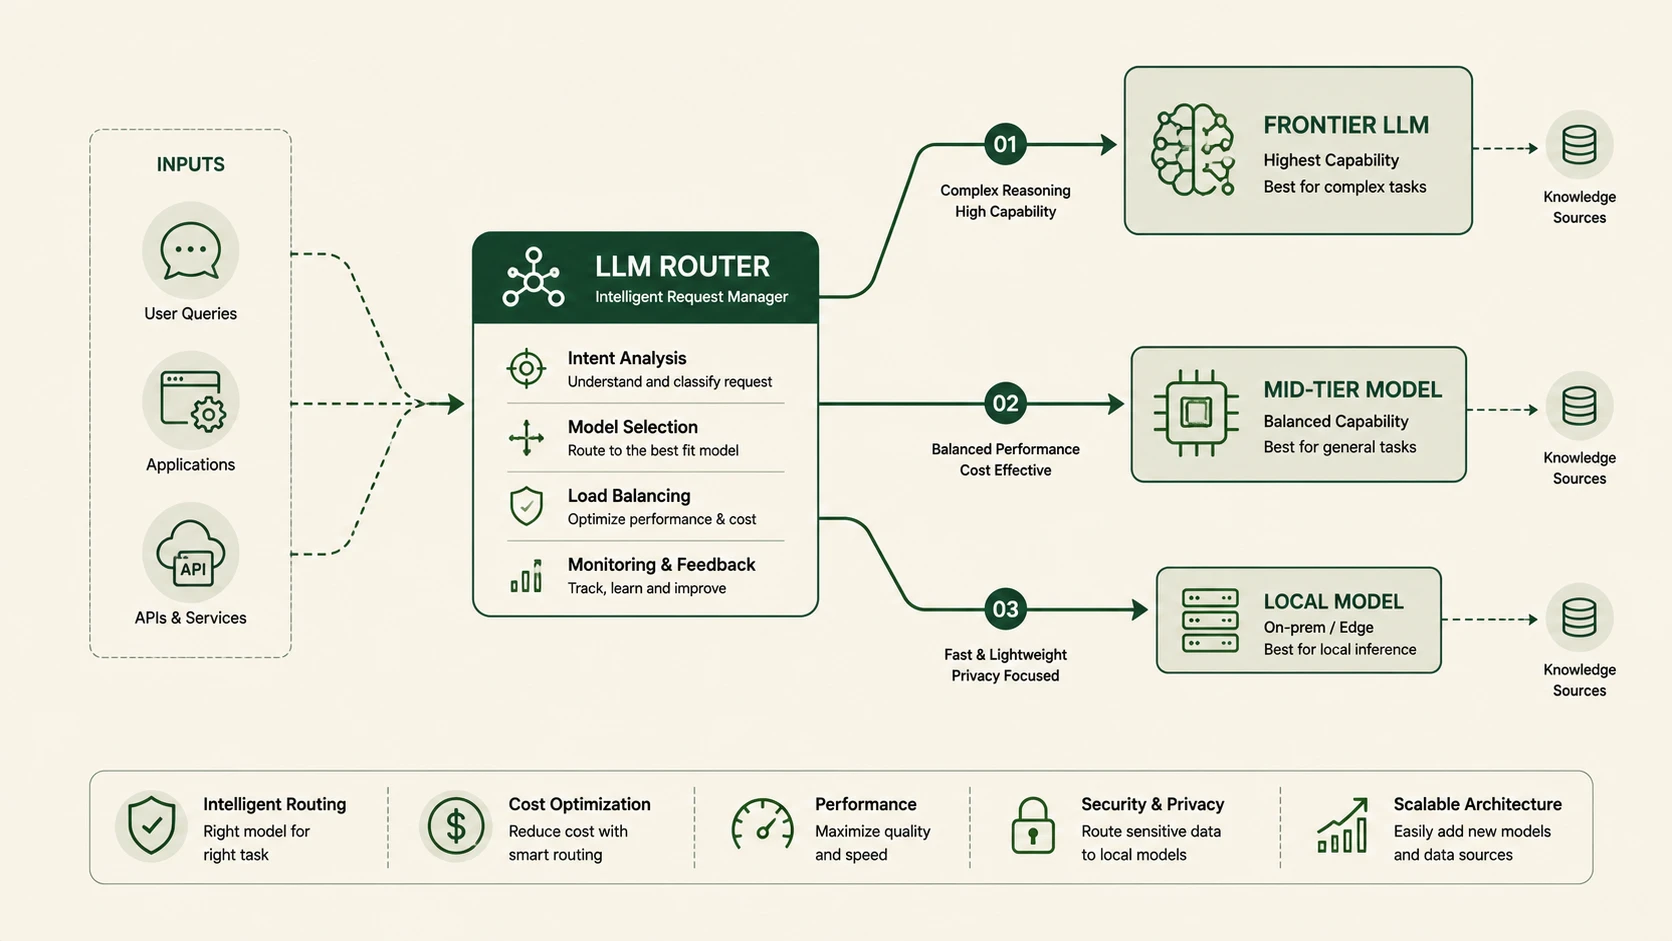
Hybrid routing is an architectural strategy that evaluates a request and routes it to the most appropriate model based on predefined criteria.
Instead of relying on a single LLM, organizations maintain multiple model tiers.
Typical routing categories include:
| Tier | Purpose |
|---|---|
| Small Models | Classification and extraction |
| Mid-Tier Models | Summarization and retrieval |
| Premium Models | Advanced reasoning |
| Specialized Models | Domain-specific workloads |
The routing engine evaluates factors such as:
- ◆Request complexity
- ◆Required accuracy
- ◆Context size
- ◆Latency requirements
- ◆Security requirements
- ◆Cost constraints
The objective is simple.
Use the lowest-cost model capable of delivering acceptable results.
Core Architecture
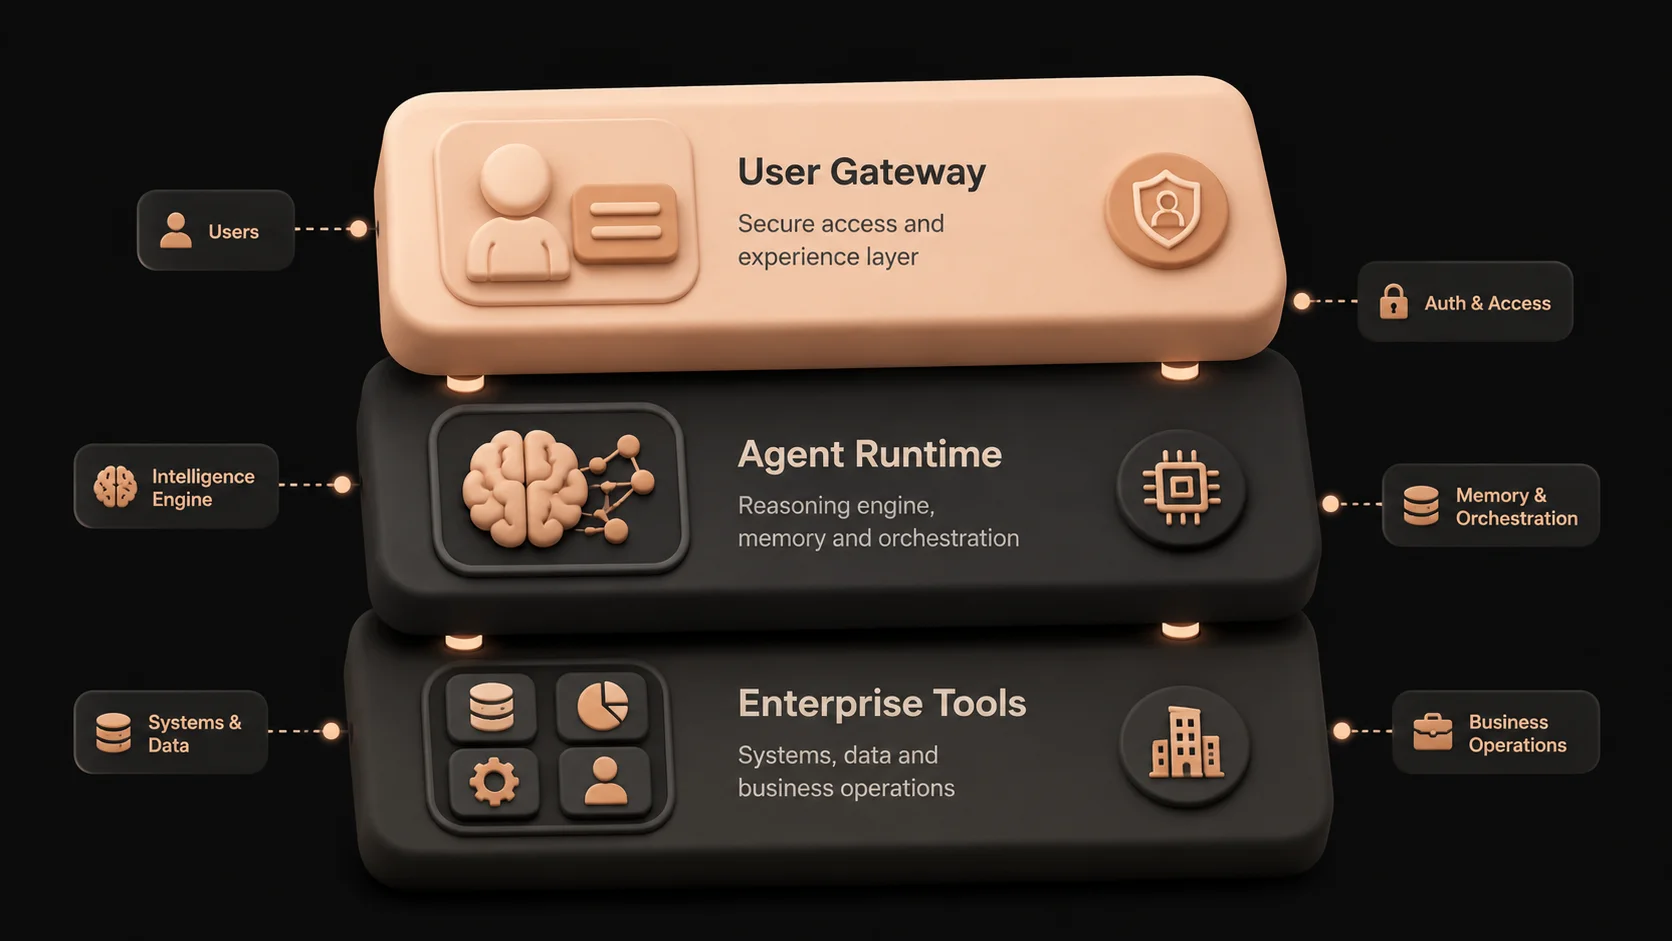
A production AI FinOps platform typically includes several architectural layers.
Request Layer
Receives requests from:
- ◆Web applications
- ◆APIs
- ◆Internal tools
- ◆AI agents
- ◆Enterprise systems
Routing Layer
Evaluates workload characteristics.
Responsibilities include:
- ◆Intent classification
- ◆Complexity scoring
- ◆Model selection
- ◆Policy enforcement
Model Layer
Contains multiple model tiers.
Examples include:
- ◆Small language models
- ◆Mid-tier reasoning models
- ◆Premium reasoning models
- ◆Specialized domain models
Observability Layer
Captures:
- ◆Token consumption
- ◆Response latency
- ◆Cost metrics
- ◆Error rates
- ◆User satisfaction indicators
Governance Layer
Provides:
- ◆Budget controls
- ◆Usage policies
- ◆Compliance monitoring
- ◆Access controls
- ◆Audit logging
Key Features
Hybrid routing platforms provide several enterprise advantages.
Dynamic Model Selection
Requests are matched to the most appropriate model.
Cost-Aware Decision Making
Routing decisions incorporate cost considerations.
Policy-Based Governance
Organizations can define routing rules aligned with business objectives.
Observability
Every inference request becomes measurable.
Scalability
Workloads distribute efficiently across model tiers.
How It Works
Consider a corporate knowledge assistant.
A user submits:
"Summarize this policy document."
The routing process may proceed as follows:
- 1.Request enters the routing engine.
- 2.Complexity classifier evaluates requirements.
- 3.Context length is calculated.
- 4.Governance policies are checked.
- 5.Appropriate model tier is selected.
- 6.Response is generated.
- 7.Cost and performance metrics are recorded.
Now consider a different request:
"Analyze the architectural trade-offs between event-driven and service-oriented integration patterns for a regulated financial institution."
The complexity score increases significantly.
The routing engine may select a premium reasoning model.
Both requests receive appropriate resources without applying premium pricing to every workload.
Enterprise Use Cases
Internal Knowledge Systems
Knowledge assistants frequently process retrieval and summarization workloads.
These tasks often perform effectively on lower-cost models.
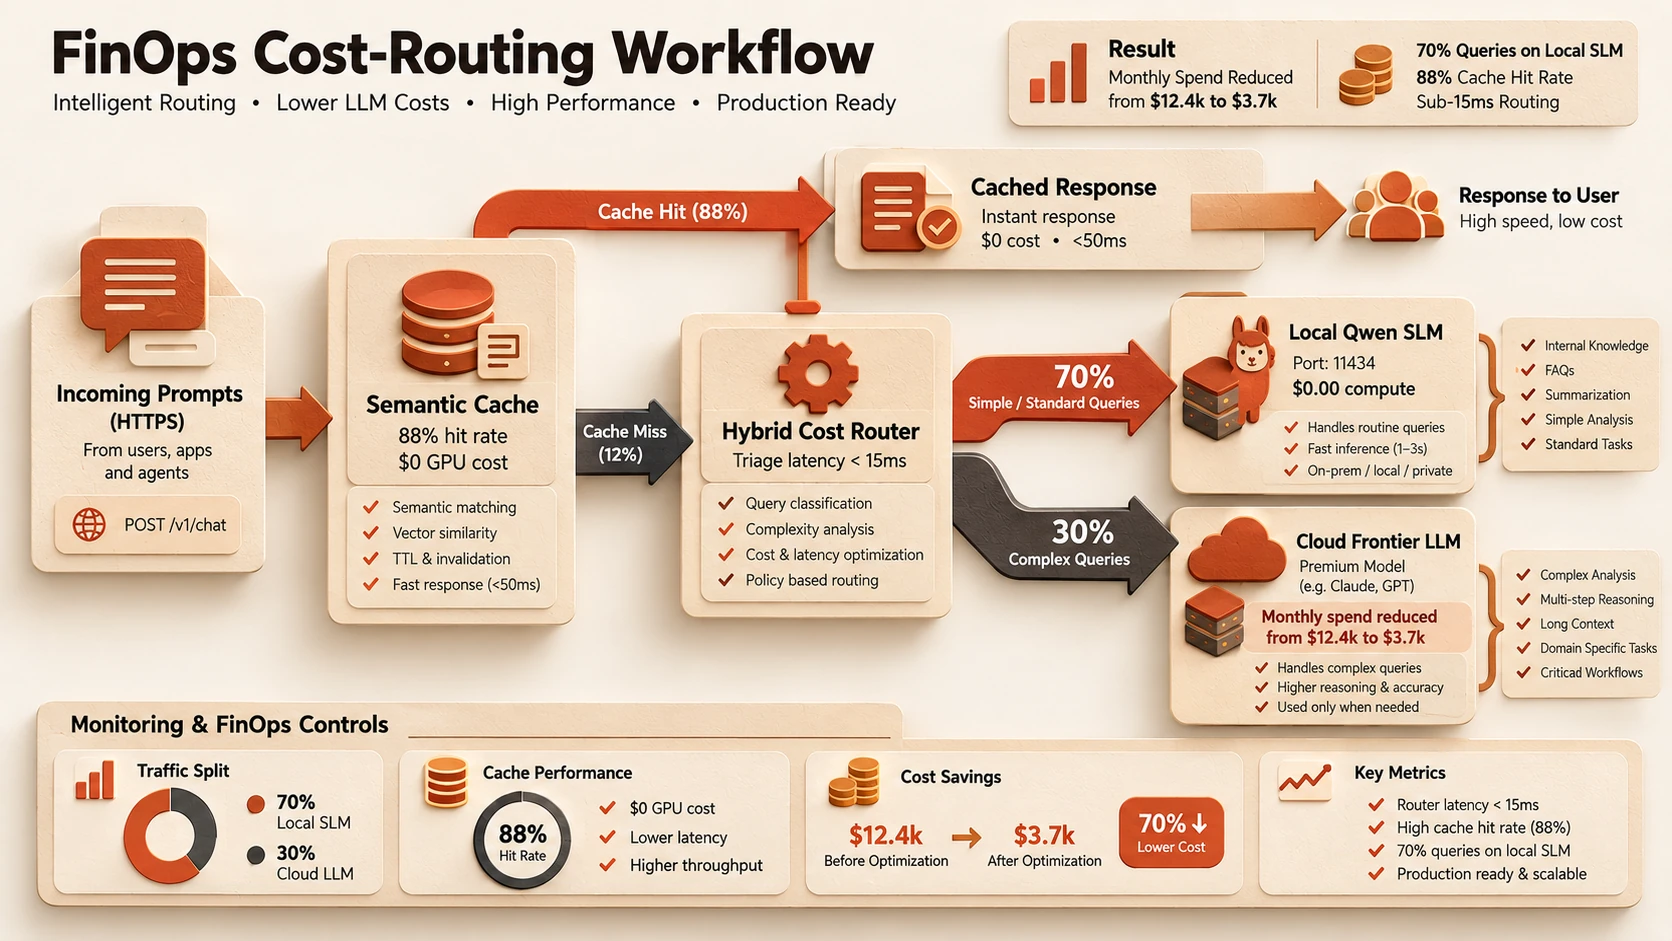
Hybrid routing and FinOps architecture illustrating semantic cache filtering and complexity-based model triage.
Customer Support
Support workflows commonly include:
- ◆Classification
- ◆Ticket routing
- ◆Response generation
- ◆Escalation recommendations
Routing strategies can substantially reduce operational costs.
Software Engineering
Development teams increasingly use AI for:
- ◆Code review
- ◆Documentation generation
- ◆Architecture guidance
- ◆Test creation
Different development tasks require different reasoning capabilities.
Agentic AI Systems
Multi-agent platforms often generate significant token consumption.
Hybrid routing enables:
- ◆Planner optimization
- ◆Validator optimization
- ◆Retrieval optimization
- ◆Agent specialization
Document Processing
Extraction and transformation workloads rarely require premium reasoning capabilities.
These workloads represent strong candidates for lower-cost model tiers.
Performance Considerations
Cost optimization should never compromise business outcomes.
Engineering teams should monitor:
| Metric | Importance |
|---|---|
| Response quality | Business value |
| Accuracy | Reliability |
| Latency | User experience |
| Cost per request | Efficiency |
| Token consumption | Optimization |
| Model utilization | Resource planning |
Successful routing systems balance quality, performance, and cost.
Security Considerations
AI FinOps initiatives must align with enterprise security requirements.
Data Classification
Sensitive workloads may require specific model policies.
Access Controls
Model access should follow least-privilege principles.
Audit Logging
Organizations should track:
- ◆Model selection decisions
- ◆User activity
- ◆Cost allocation
- ◆Policy enforcement
Compliance Controls
Routing decisions should respect organizational compliance requirements.
Encryption
Prompts, responses, and operational telemetry should remain protected during transmission and storage.
Scalability
As AI adoption expands, routing architecture becomes increasingly important.
A scalable hybrid routing platform supports:
- ◆Horizontal scaling
- ◆Distributed inference
- ◆Multi-region deployments
- ◆Load balancing
- ◆Queue management
- ◆Elastic capacity planning
By distributing workloads across multiple model tiers, organizations can improve scalability while maintaining predictable spending patterns.
Best Practices
Measure Before Optimizing
Establish baseline metrics before introducing routing changes.
Define Workload Categories
Classify workloads according to complexity and business value.
Implement Cost Visibility
Every request should be measurable.
Use Progressive Rollouts
Introduce routing policies gradually.
Monitor Quality Metrics
Optimization efforts should preserve acceptable response quality.
Establish Governance
Create clear ownership for AI spending and optimization.
Common Mistakes
Using Premium Models Everywhere
This remains one of the largest contributors to excessive AI spending.
Optimizing Only for Cost
Aggressive cost reduction can negatively impact business outcomes.
Ignoring Observability
Without visibility, optimization becomes guesswork.
Missing Ownership
AI spending requires accountability.
Lack of Routing Policies
Uncontrolled model usage increases financial risk.
Technology Comparison
Single Model vs Hybrid Routing
| Factor | Single Model | Hybrid Routing |
|---|---|---|
| Cost Efficiency | Low | High |
| Operational Flexibility | Limited | High |
| Governance | Moderate | High |
| Scalability | Moderate | High |
| Resource Utilization | Low | High |
| Budget Predictability | Limited | Improved |
Traditional FinOps vs AI FinOps
| Area | Traditional FinOps | AI FinOps |
|---|---|---|
| Primary Resource | Compute and Storage | Tokens and Inference |
| Cost Driver | Infrastructure Usage | Model Consumption |
| Optimization Target | Cloud Resources | AI Workloads |
| Governance Focus | Infrastructure | Models and Agents |
Adoption Strategy
Organizations should adopt AI FinOps incrementally.
Phase 1: Visibility
Capture token usage, model consumption, and cost metrics.
Phase 2: Classification
Categorize workloads according to complexity.
Phase 3: Routing
Introduce policy-based model selection.
Phase 4: Governance
Implement budgets, alerts, and accountability controls.
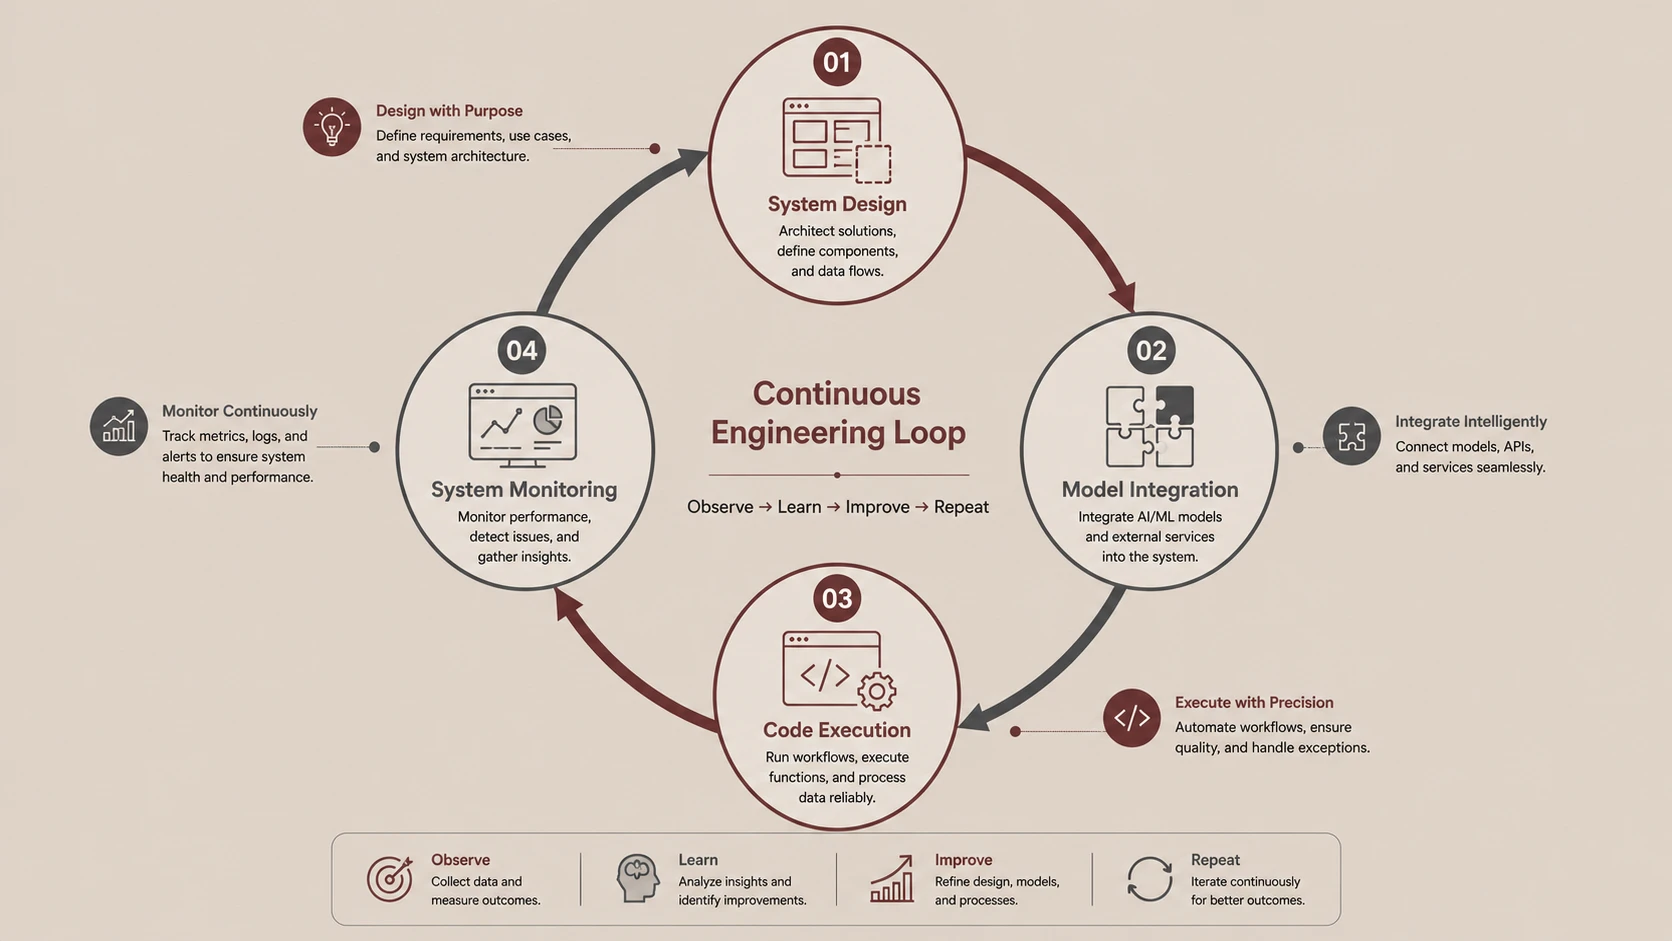
Phase 5: Continuous Optimization
Refine routing decisions using operational data.
This phased approach reduces risk while improving organizational maturity.
Limitations
Hybrid routing is powerful but not without challenges.
Common limitations include:
- ◆Routing complexity
- ◆Policy maintenance overhead
- ◆Model evaluation requirements
- ◆Governance responsibilities
- ◆Quality measurement challenges
Organizations should evaluate optimization opportunities carefully and maintain strong operational oversight.
Looking Ahead
As of October 2026, AI spending has become a significant operational consideration for organizations deploying large language models at scale. Hybrid routing is emerging as a practical architectural pattern that aligns AI consumption with workload requirements.
Rather than treating every request as a premium reasoning problem, enterprises are increasingly applying FinOps principles to AI platforms through workload classification, model tiering, governance controls, and observability.
The organizations achieving the greatest efficiency are not necessarily using fewer AI capabilities. Instead, they are focusing on using the right capability for the right workload. Hybrid routing provides a structured framework for balancing cost, performance, scalability, and business value while supporting sustainable enterprise AI adoption.